Bốn model cùng dẫn đầu bài benchmark 17 model embedding của Ollama: embeddinggemma-2, qwen3-embedding:8b, embeddinggemma và qwen3-embedding:4b, đều đạt điểm tổng hợp khoảng 0,73. Điều phân biệt chúng là chi phí: embeddinggemma, một model 300 triệu tham số, chạy xong bộ 9 task trong 423 giây, còn qwen3-embedding:8b cần 3.064 giây cho một điểm số gần như bằng nhau.
Chúng tôi chạy từng model đúng như Ollama phục vụ, tức bản đã lượng tử hóa gọi qua /api/embed, trên một GPU NVIDIA L4, và chấm điểm bằng thư viện mã nguồn mở mteb. Bộ đo gồm truy xuất tài liệu tiếng Anh và tiếng Việt cho RAG, truy xuất code, độ tương đồng câu và phân loại ý định. Hai thử nghiệm bổ sung kiểm tra finetune cho dữ liệu pháp lý tiếng Việt và truy xuất trang tài liệu dạng ảnh.
Nên chọn model nào?
Mặc định:
embeddinggemma, model nhanh nhất trong nhóm dẫn đầu.Tiếng Việt hoặc code:
qwen3-embedding:4b, hoặc:8bnếu không ngại thời gian chạy.Cần nhận ảnh:
embeddinggemma-2, model embedding duy nhất trong danh mục Ollama nhận được ảnh.Nên tránh: model chỉ hỗ trợ tiếng Anh cho dữ liệu tiếng Việt, và
laya, model không trả về embedding dùng được.
Kết quả chính
- Không có model thắng rõ ràng. Bốn model đầu cách nhau chỉ 0,009, nhỏ hơn mức một lần chạy có thể phân biệt.
- Thời gian chạy chênh 7 lần. Trong nhóm đầu, tổng thời gian chạy dao động từ 423 đến 3.064 giây.
- Tiếng Việt phân hóa rõ nhất. Trên SciFact-VN, model đa ngôn ngữ đạt 0,63–0,74, còn model chỉ hỗ trợ tiếng Anh chỉ đạt 0,11–0,42.
- Với code, model lớn hơn không tốt hơn.
qwen3-embedding:4bdẫn đầu hai trong ba task code; bản 8B không cải thiện thêm. - Finetune đáng làm. 133 giây huấn luyện nâng
paraphrase-multilingualtừ 0,500 lên 0,785 nDCG@10 trên dữ liệu pháp lý tiếng Việt.
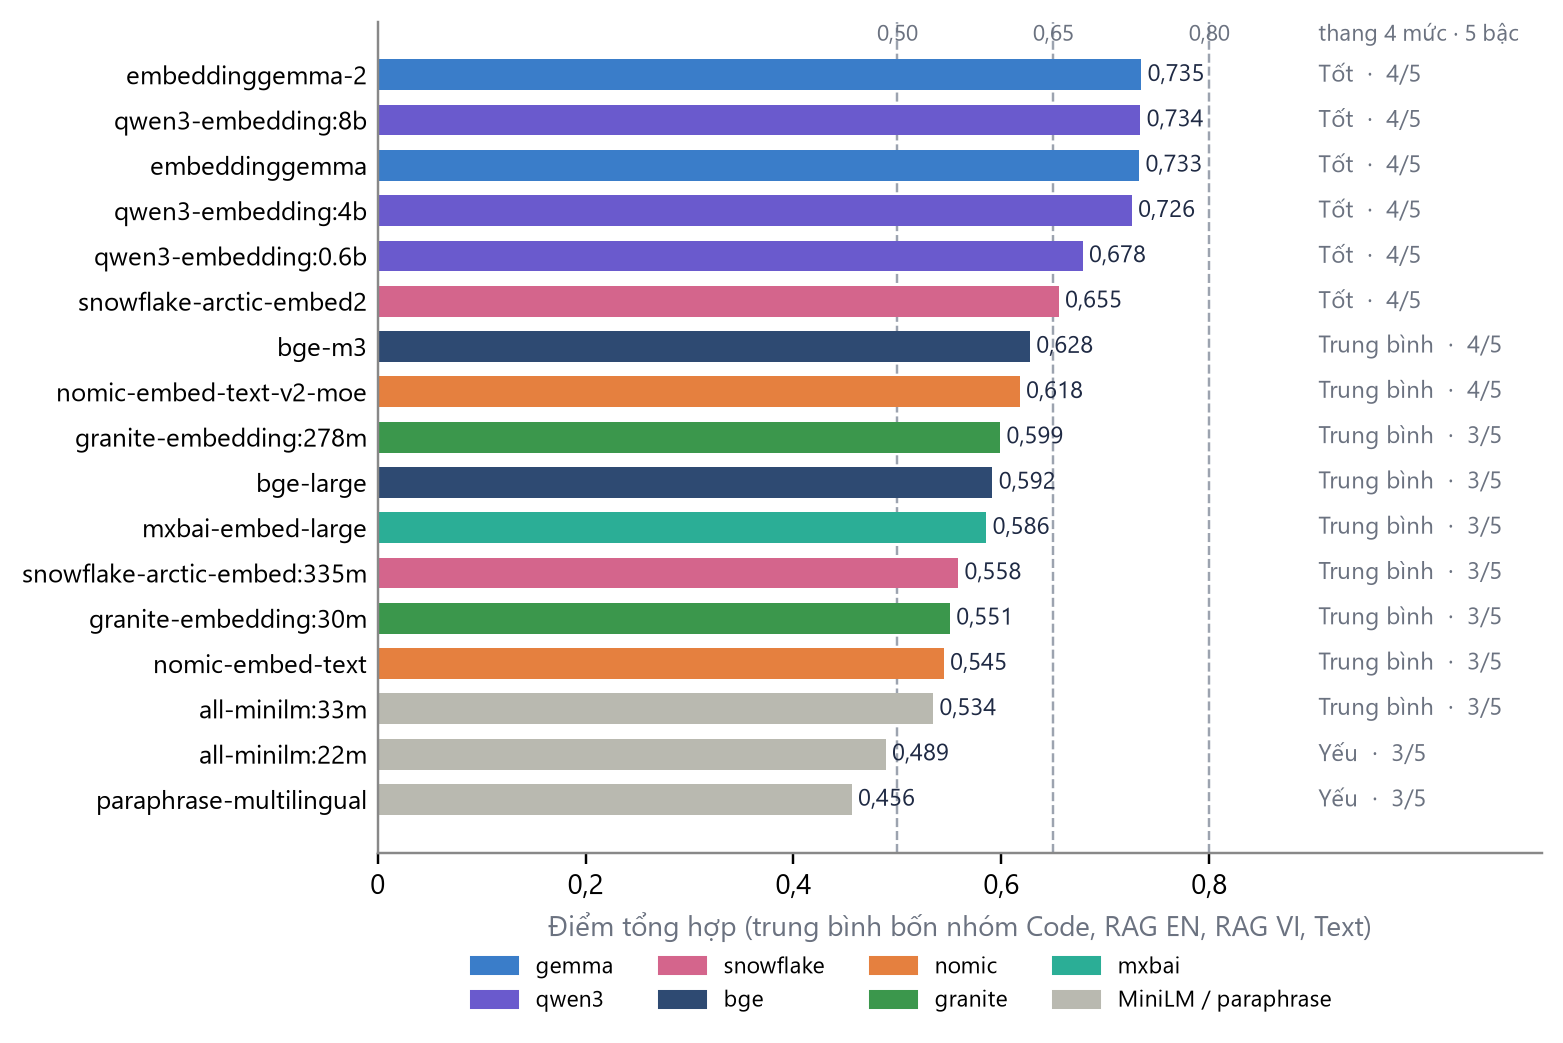
Hình 1. Điểm tổng hợp của 17 model. Nét đứt là ranh giới các mức đánh giá trong báo cáo; màu thể hiện họ model.
Cách chúng tôi đo
| Thành phần | Cấu hình |
|---|---|
| Ngày chạy | 25/10/2026 |
| Phần cứng | Google Colab Pro, NVIDIA L4 (23 GB VRAM), RAM 52 GB |
| Phần mềm | Ollama 0.40.11, mteb 2.26.21 |
| Model | 17 model embedding của Ollama; 153 kết quả (17 model × 9 task) |
| Cách gọi embedding | /api/embed, context 2.048 token cho mọi model, vector chuẩn hóa L2 |
| Prefix | Prefix query và document theo model card của từng model |
| Nhóm | Task | Đo gì | Metric |
|---|---|---|---|
| RAG tiếng Anh | NanoSciFact, NanoNFCorpus, NanoNQ | Truy xuất tài liệu trên các tập NanoBEIR | nDCG@10 |
| RAG tiếng Việt | SciFact-VN | Truy xuất trên bản dịch tiếng Việt của SciFact (VN-MTEB) | nDCG@10 |
| Code | CodeTransOceanDL, CodeTransOceanContest | Tìm code tương đương giữa các ngôn ngữ và framework | nDCG@10 |
| Code | CodeRAGProgrammingSolutions | Xếp hạng lại lời giải ứng viên | nDCG@10 |
| Text | STSBenchmark | Độ tương đồng câu | Spearman |
| Text | Banking77Classification | Phân loại ý định | Accuracy |
Điểm tổng hợp là trung bình không trọng số của bốn nhóm. Vì nhóm RAG tiếng Việt chỉ có một task, riêng SciFact-VN chiếm 25% điểm tổng hợp. Điểm 0,73 là chỉ số tóm tắt của thiết kế benchmark này, không phải độ chính xác 73%.
Chất lượng gần nhau, thời gian chạy rất khác
| Model | Điểm tổng hợp | SciFact-VN | Tổng thời gian |
|---|---|---|---|
| embeddinggemma-2 | 0,735 | 0,712 | 521 giây |
| qwen3-embedding:8b | 0,734 | 0,740 | 3.064 giây |
| embeddinggemma | 0,733 | 0,705 | 423 giây |
| qwen3-embedding:4b | 0,726 | 0,738 | 1.884 giây |
| qwen3-embedding:0.6b | 0,678 | 0,674 | 577 giây |
| snowflake-arctic-embed2 | 0,655 | 0,651 | 524 giây |
| bge-m3 | 0,628 | 0,626 | 520 giây |
| nomic-embed-text-v2-moe | 0,618 | 0,657 | 398 giây |
| granite-embedding:278m | 0,599 | 0,571 | 311 giây |
| bge-large | 0,592 | 0,420 | 500 giây |
| mxbai-embed-large | 0,586 | 0,402 | 492 giây |
| snowflake-arctic-embed:335m | 0,558 | 0,393 | 489 giây |
| granite-embedding:30m | 0,551 | 0,374 | 267 giây |
| nomic-embed-text | 0,545 | 0,390 | 346 giây |
| all-minilm:33m | 0,534 | 0,236 | 455 giây |
| all-minilm:22m | 0,489 | 0,106 | 333 giây |
| paraphrase-multilingual | 0,456 | 0,393 | 319 giây |
embeddinggemma cho điểm ngang qwen3-embedding:8b với thời gian chạy ít hơn 7,2 lần. Trong họ Qwen3, thời gian tăng nhanh hơn nhiều so với chất lượng: bản 0.6B mất 577 giây (0,678), bản 4B mất 1.884 giây (0,726) và bản 8B mất 3.064 giây (0,734). Đây là tổng thời gian cả bộ test, gồm nạp model và có lúc dùng chung GPU, nên chỉ phản ánh chi phí tương đối, không phải latency mỗi truy vấn.
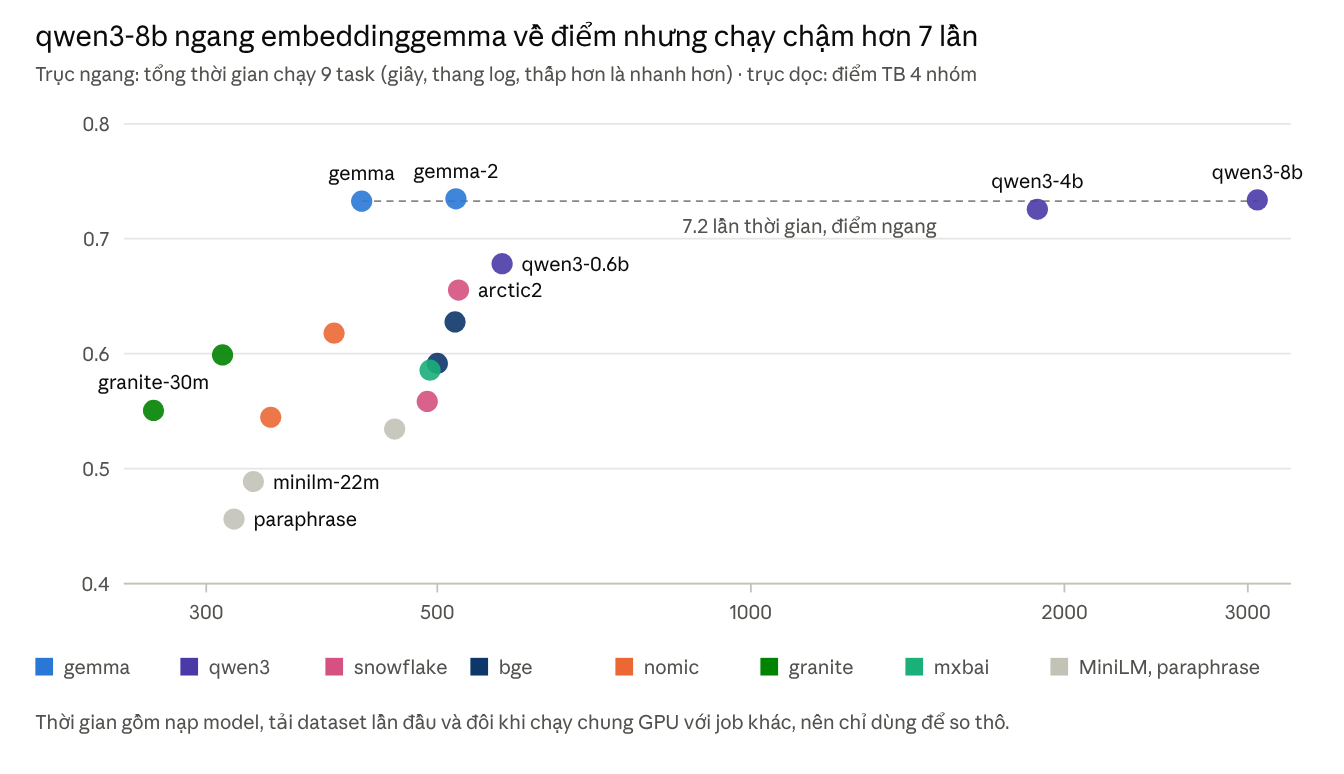
Hình 2. Điểm tổng hợp theo tổng thời gian chạy (trục thời gian thang log).
Tiếng Việt: điểm tiếng Anh không chuyển sang được
Các model chủ yếu cho tiếng Anh tụt mạnh với tiếng Việt: all-minilm:22m chỉ đạt 0,106, còn mxbai-embed-large, bge-large và nomic-embed-text chỉ đạt 0,39–0,42. Các model đa ngôn ngữ, gồm họ Qwen3 và gemma, nomic-embed-text-v2-moe, snowflake-arctic-embed2 và bge-m3, giữ được 0,63–0,74.
SciFact-VN được dịch máy từ tiếng Anh, nên nó kiểm tra văn bản tiếng Việt nhưng chưa phản ánh từ vựng, viết tắt và cách diễn đạt của tài liệu tiếng Việt gốc. Một hệ thống RAG tiếng Việt vẫn cần bộ đánh giá riêng.
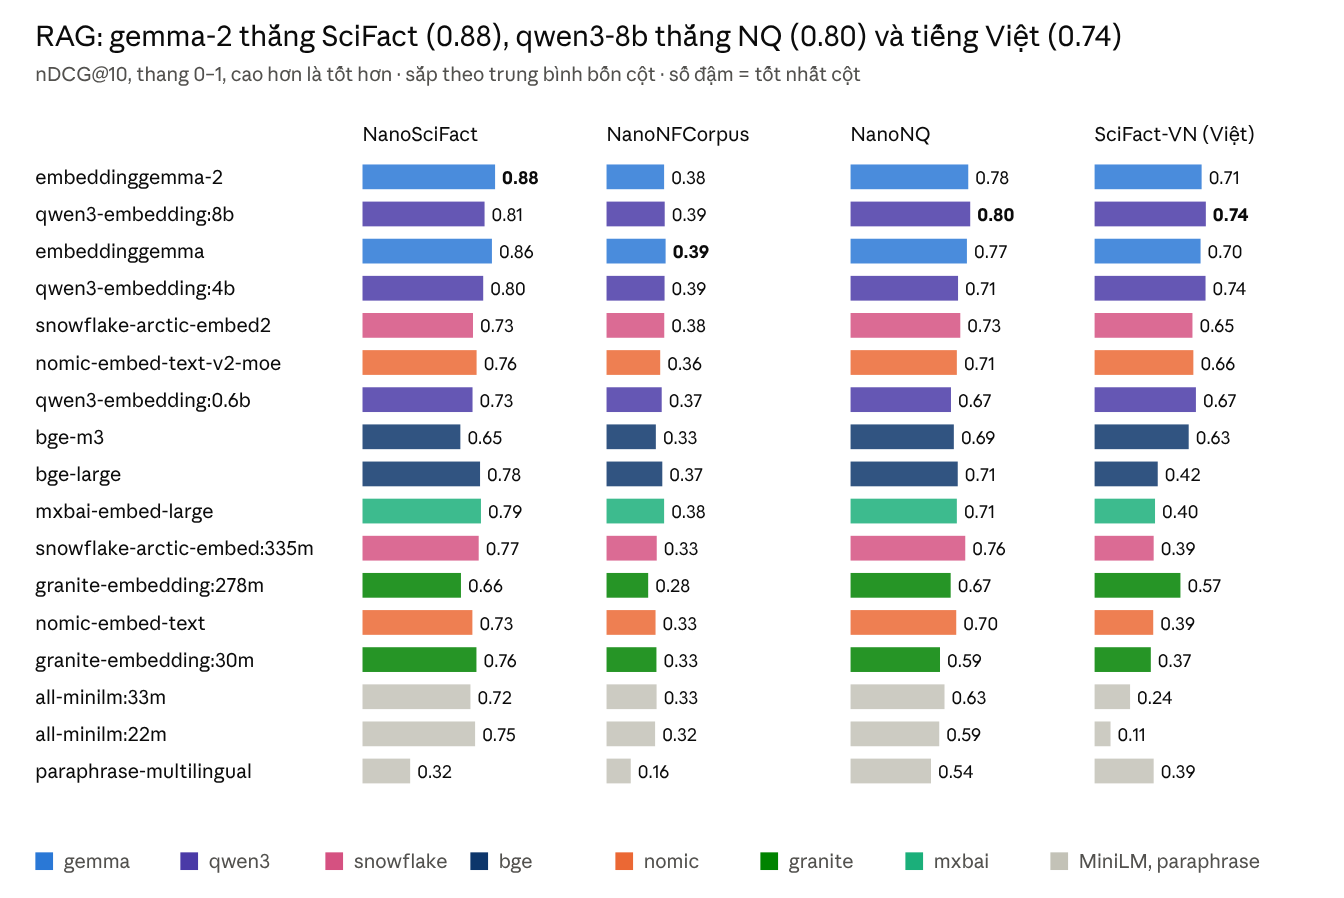
Hình 3. nDCG@10 trên bốn task truy xuất. Số in đậm là giá trị cao nhất mỗi cột.
Code: bản 4B là đủ
qwen3-embedding:4b đạt 0,920 trên CodeTransOceanContest và 0,768 trên CodeRAGProgrammingSolutions, so với 0,908 và 0,757 của bản 8B. Hai model gemma theo sát phía sau. CodeTransOcean đo khả năng tìm code tương đương về chức năng, không phải tìm code từ câu hỏi ngôn ngữ tự nhiên, nên tìm kiếm trong repository vẫn cần bộ đánh giá dựng từ truy vấn thật của người dùng.
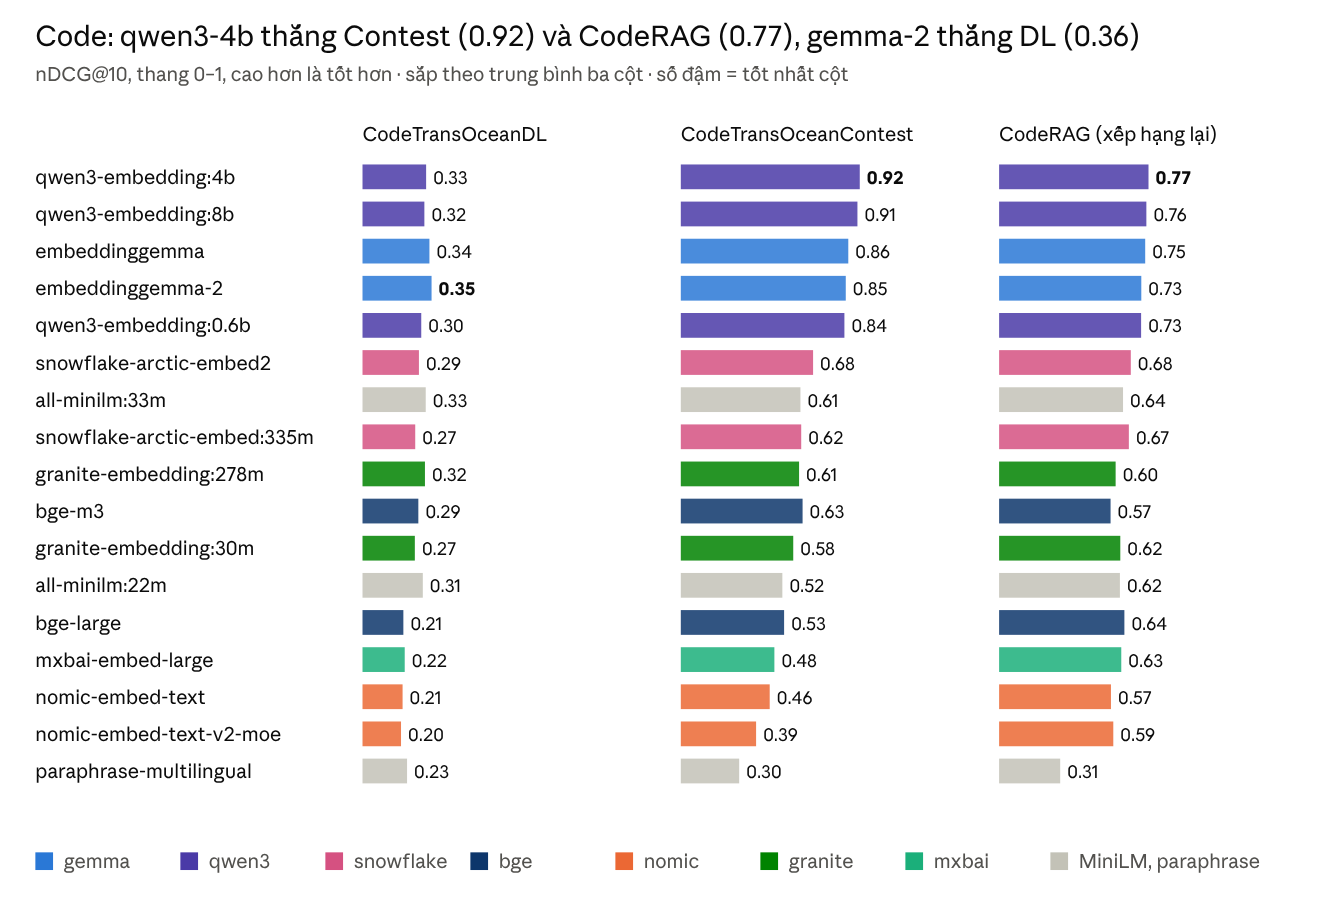
Hình 4. nDCG@10 trên ba task code.
Text: so độ giống câu và phân loại ưu tiên model khác nhau
mxbai-embed-large có điểm STS cao nhất (0,893), còn embeddinggemma-2 dẫn đầu phân loại ý định Banking77 (0,923). Ba điểm STS cao nhất cách nhau dưới 0,02; Banking77 phân tách rõ hơn, với cả hai model gemma trên 0,91.
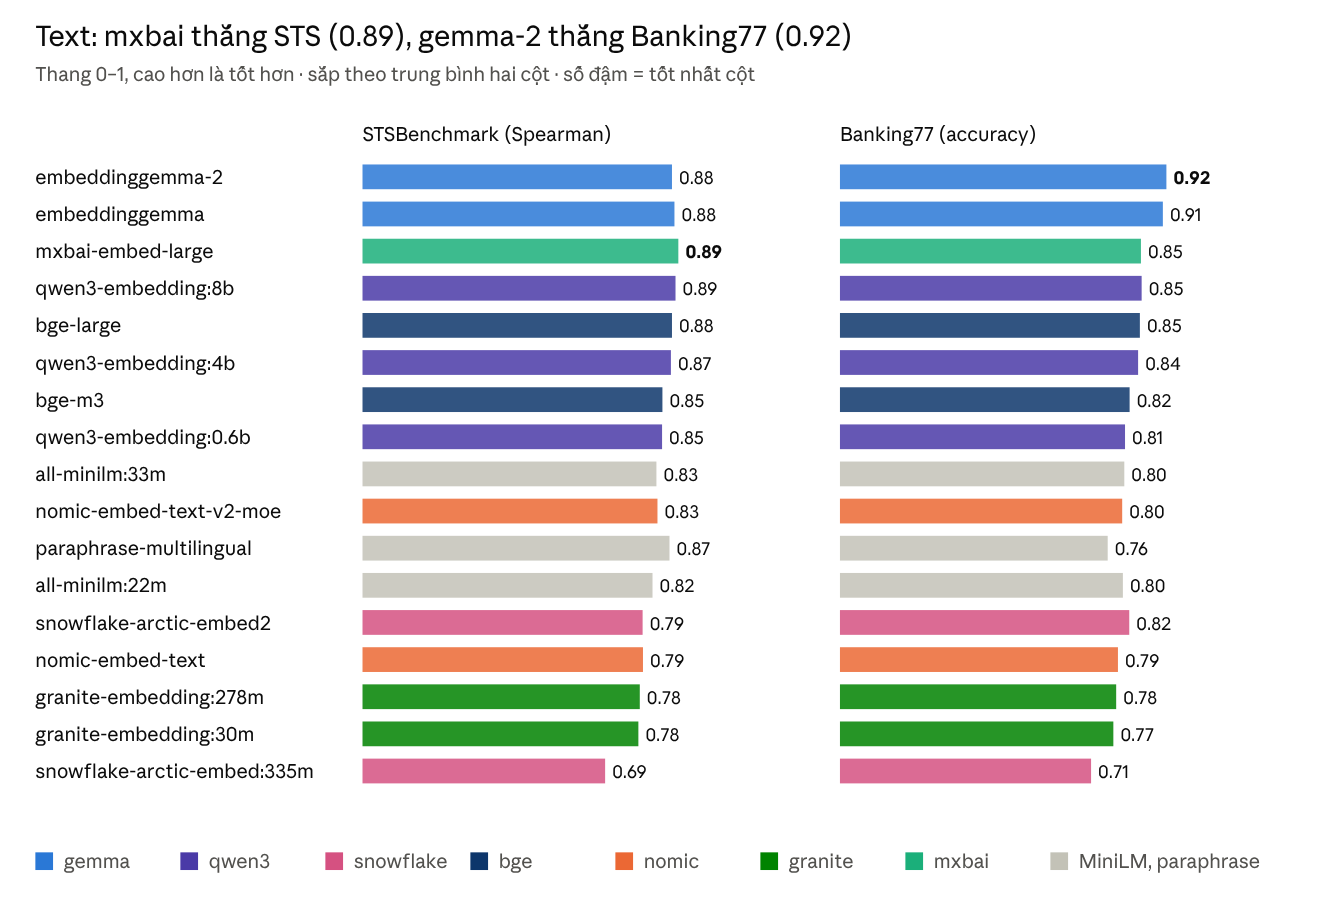
Hình 5. STSBenchmark (tương quan Spearman) và Banking77 (accuracy phân loại).
Thử nghiệm bổ sung: finetune cho văn bản pháp lý tiếng Việt
Ollama không finetune được, nên chúng tôi huấn luyện checkpoint Hugging Face tương ứng trên 2.505 cặp câu hỏi–điều luật của Zalo AI Legal Text Retrieval, rồi đánh giá trên 788 câu hỏi test với corpus rút gọn 8.447 đoạn. Huấn luyện dùng MultipleNegativesRankingLoss, batch 32, learning rate 2e-5, 3 epoch, tối đa 256 token.
| Checkpoint Hugging Face | nDCG@10 trước | nDCG@10 sau | Thời gian train |
|---|---|---|---|
| paraphrase-multilingual-mpnet-base-v2 | 0,500 | 0,785 | 133 giây |
| granite-embedding-278m-multilingual | 0,741 | 0,790 | 93 giây |
Trên SciFact-VN, hai checkpoint này chỉ thay đổi +0,034 và −0,009, nên mức tăng trên văn bản pháp lý không đi kèm suy giảm rõ ở miền khác. Đây là checkpoint tách biệt với model Ollama, và điểm của chúng không nằm trong bảng xếp hạng chính.
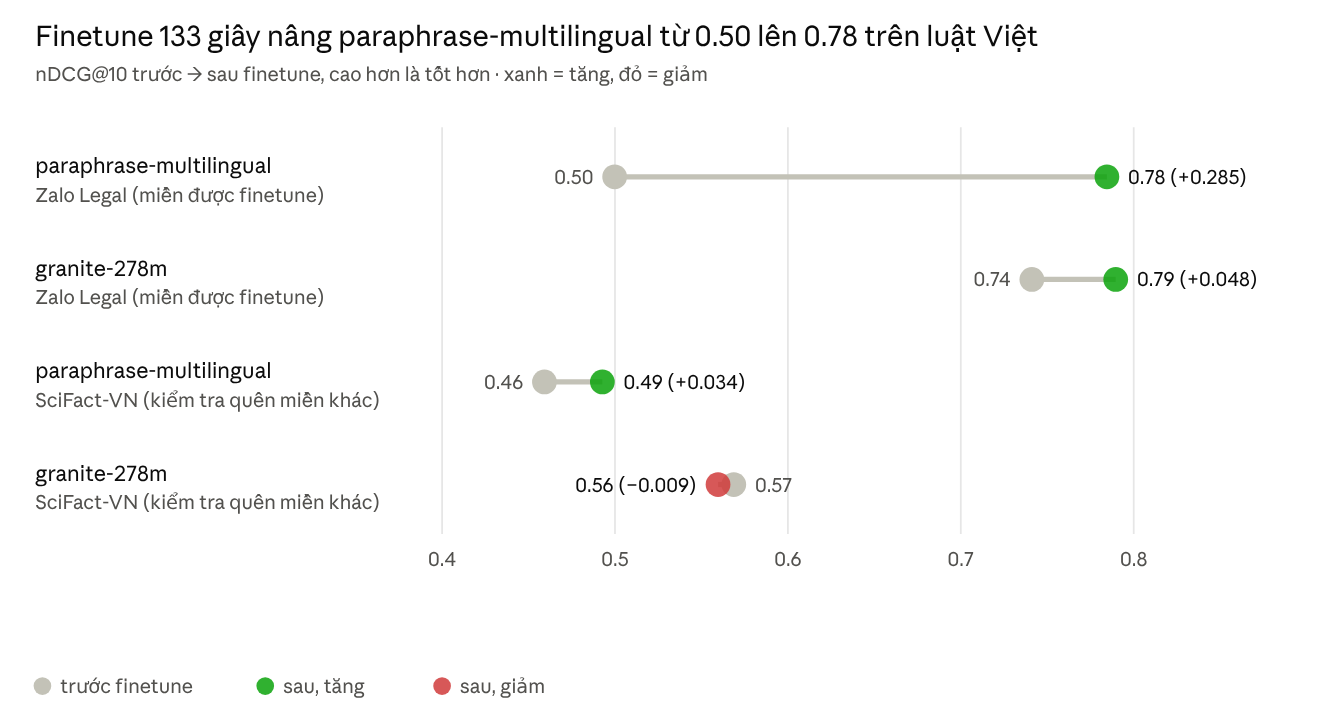
Hình 6. nDCG@10 trước và sau finetune, với SciFact-VN để kiểm tra miền khác.
Thử nghiệm bổ sung: truy xuất trang tài liệu dạng ảnh
embeddinggemma-2 là model duy nhất trong danh mục embedding của Ollama nhận được ảnh. Với câu hỏi dạng chữ và trang tài liệu dạng ảnh, nó đạt nDCG@5 là 0,84 trên TabFQuAD, 0,89 trên SyntheticDocQA-AI và 0,63 trên ArxivQA, ba task thuộc benchmark ViDoRe v1. Ảnh phải được gửi dưới dạng input: [{"image": <base64>}]; trong các lần kiểm tra của chúng tôi, trường images bị bỏ qua hoàn toàn. Hai tag latest (740m) và 440m cho embedding giống hệt nhau trong các phép thử.
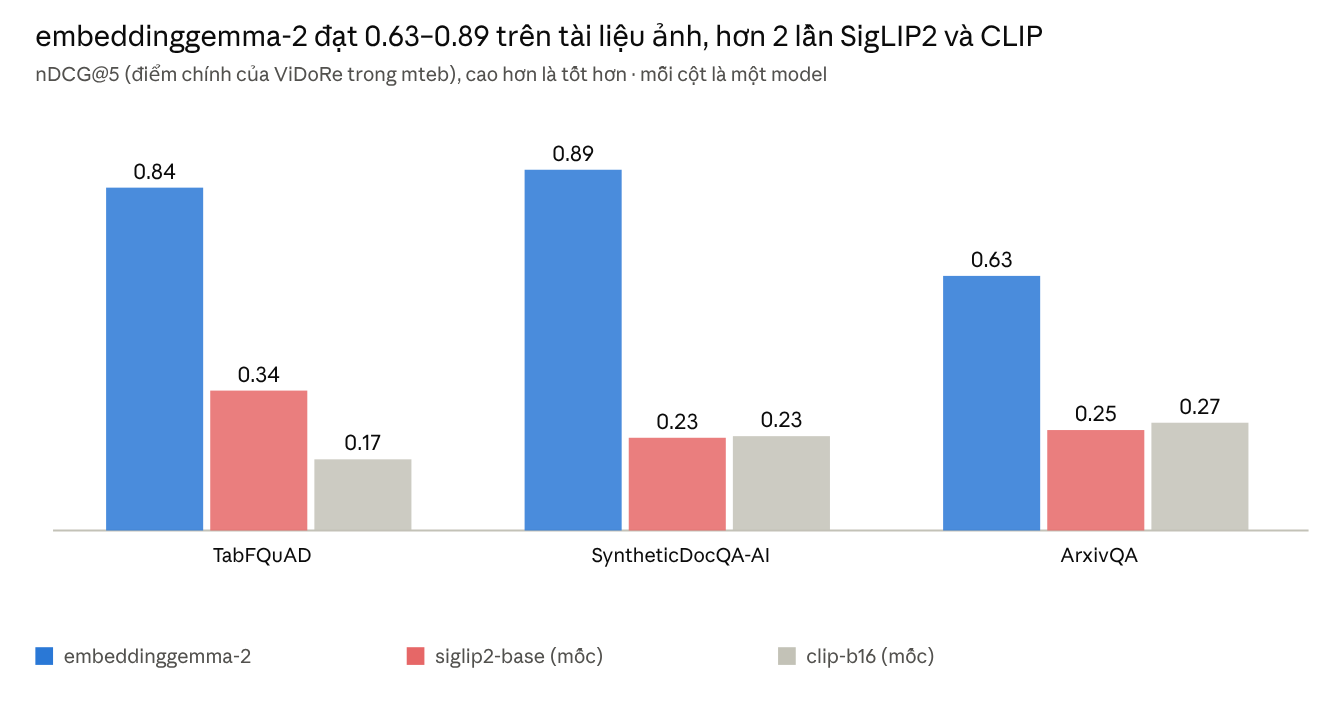
Hình 7. nDCG@5 trên ba task ViDoRe v1. SigLIP2 và CLIP là mốc tham chiếu chạy qua Hugging Face với pipeline khác.
Gợi ý của tác giả theo nhu cầu (ý kiến cá nhân)
Các gợi ý dưới đây là ý kiến cá nhân của tác giả. Chúng dựa trên kết quả ở trên và cân nhắc giữa chất lượng với thời gian chạy trong cấu hình này; đây không phải bảng xếp hạng chung cho mọi trường hợp, nên hãy thử lại nhóm ứng viên trên dữ liệu của bạn.
| Nhu cầu | Tôi chọn | Phương án khác | Lý do |
|---|---|---|---|
| RAG tiếng Anh nói chung | embeddinggemma | embeddinggemma-2, qwen3-embedding:4b | Chất lượng nhóm đầu với thời gian chạy thấp nhất trong nhóm (423 giây) |
| RAG trên tài liệu tiếng Việt | qwen3-embedding:4b | qwen3-embedding:8b, embeddinggemma-2 | SciFact-VN 0,738, ngang bản 8B (0,740) với khoảng 60% thời gian chạy |
| Kho tri thức trộn tiếng Việt và tiếng Anh | embeddinggemma-2 | qwen3-embedding:4b | Mạnh ở cả hai ngôn ngữ: NanoSciFact 0,882, SciFact-VN 0,712 |
| Tìm kiếm code và trợ lý lập trình | qwen3-embedding:4b | embeddinggemma, qwen3-embedding:8b | Cao nhất ở CodeTransOceanContest (0,920) và CodeRAG (0,768) |
| So độ giống câu, lọc trùng lặp | mxbai-embed-large | qwen3-embedding:8b, embeddinggemma | Điểm STS cao nhất (0,893); chỉ hỗ trợ tiếng Anh |
| Phân loại ý định, định tuyến câu hỏi | embeddinggemma-2 | embeddinggemma | Accuracy Banking77 là 0,923 và 0,913 |
| Tài liệu scan, slide, trang PDF dạng ảnh | embeddinggemma-2 | — | Model duy nhất nhận ảnh; nDCG@5 trên ViDoRe từ 0,63 đến 0,89 |
| Máy cấu hình yếu | embeddinggemma | granite-embedding:30m (chỉ tiếng Anh) | 300 triệu tham số mà chất lượng vẫn ở nhóm đầu; granite-embedding:30m là model chạy nhanh nhất (267 giây) |
| Finetune cho một miền tiếng Việt | granite-embedding:278m | paraphrase-multilingual | Điểm xuất phát tốt (0,741 → 0,790); paraphrase-multilingual tăng nhiều nhất (+0,285) |
Hạn chế
- Chín task, mỗi task chạy một lần, không có khoảng tin cậy; nên coi chênh lệch dưới khoảng 0,02 là nhiễu.
- Các tập NanoBEIR và corpus pháp lý rút gọn chưa phản ánh quy mô production.
- Lượng tử hóa GGUF, context 2.048 token và prefix có thể làm điểm khác checkpoint gốc.
embeddinggemma-2dùng tạm prefix của thế hệ trước, và Qwen3 dùng một instruction chung. - Thời gian chưa được đo trên GPU riêng; chưa ghi lại latency mỗi truy vấn và bộ nhớ đỉnh.
- Finetune
mxbai-embed-largebị sụp loss ở mọi lần thử, còn bản Hugging Face củanomic-embed-textvàembeddinggemmachưa finetune được trong môi trường của chúng tôi. Điều này không có nghĩa các model đó không thể finetune.
Áp dụng vào dự án của bạn
Dùng kết quả này để chọn hai hoặc ba ứng viên, rồi đo lại trên truy vấn và tài liệu của chính bạn trong cùng điều kiện, so cả latency, bộ nhớ và chi phí bên cạnh chất lượng truy xuất. Với RAG tiếng Việt, hãy đưa vào tên riêng, viết tắt, dấu tiếng Việt và thuật ngữ chuyên ngành; với tìm kiếm code, đưa vào truy vấn ngôn ngữ tự nhiên; khi finetune, giữ tập test độc lập và kiểm tra cả dữ liệu ngoài miền.
Nguồn và khả năng tái lập
Mọi số liệu lấy từ lần chạy benchmark ngày 25/10/2026 của chúng tôi. Báo cáo đầy đủ, gồm phương pháp, toàn bộ biểu đồ và điểm từng task của 17 model, có ở dạng PDF.
Các task benchmark được nạp qua mteb: NanoSciFactRetrieval, NanoNFCorpusRetrieval, NanoNQRetrieval, SciFact-VN, CodeTransOceanDL, CodeTransOceanContest, CodeRAGProgrammingSolutions, STSBenchmark, Banking77Classification và ba task ViDoRe v1. Dữ liệu finetune là GreenNode/zalo-ai-legal-text-retrieval-vn trên Hugging Face.
- MTEB: thư viện đánh giá embedding
- Ollama: tài liệu embeddings
- EmbeddingGemma trên Ollama
- EmbeddingGemma 2 trên Ollama
- Qwen3 Embedding trên Ollama
- Zalo AI Legal Text Retrieval, bản GreenNode
Thumbnail của bài là ảnh minh họa biên tập tạo bằng AI, không phải biểu đồ kết quả. Các trang model chỉ mô tả model; mọi điểm số trong bài là số chúng tôi tự đo, không phải số do nhà cung cấp công bố.