

d3:9b đạt 85,2 điểm, chỉ thấp hơn d3:27b 1,1 điểm trong bộ benchmark của chúng tôi. Đổi lại, độ trễ trung vị là 303 ms thay vì 870 ms, còn VRAM đỉnh giảm từ 30,7 GB xuống 11,2 GB. Với một ứng dụng cần phân loại hoặc định tuyến liên tục, đây là chênh lệch đáng để xem trước khi chọn model lớn nhất.
Chúng tôi so sánh 14 biến thể decision model chạy local qua Ollama với Jev 1.14.0, API trả phí của TypeSafe, trên tám tác vụ: đọc log, phân loại tiếng Anh, xử lý tiếng Việt và trả lời có/không. Mỗi model được đánh giá trên 1.600 quyết định, với cùng dữ liệu đầu vào và bộ câu hỏi cho từng mẫu.
pplx-decider:27b đứng đầu về điểm quan sát, đạt 86,6; Jev đạt 82,7, đứng thứ tám trong 15 cấu hình đã chạy. Tuy vậy, một lượt chạy với 200 mẫu mỗi tác vụ chưa đủ để biến các khoảng cách nhỏ thành kết luận thắng thua chắc chắn. Điều thú vị hơn là mỗi lựa chọn đánh đổi điều gì về chất lượng, độ trễ, bộ nhớ và công vận hành.
Nên chọn model nào trước?
Có GPU, cần một lựa chọn cân bằng: thử
d3:9b.Ưu tiên điểm tổng và có GPU lớn: đưa
pplx-decider:27bvàd3:27bvào danh sách thử.Không có GPU hoặc muốn giảm công vận hành: Jev vẫn là ứng viên hợp lý.
Định tuyến ý định tiếng Anh, chấm sao review: xem
clef-flash:9b.Xử lý tiếng Việt: thử trực tiếp trên dữ liệu của bạn; điểm tiếng Anh không đủ để quyết định.
Đây là gợi ý cá nhân của tác giả trong phạm vi benchmark này.
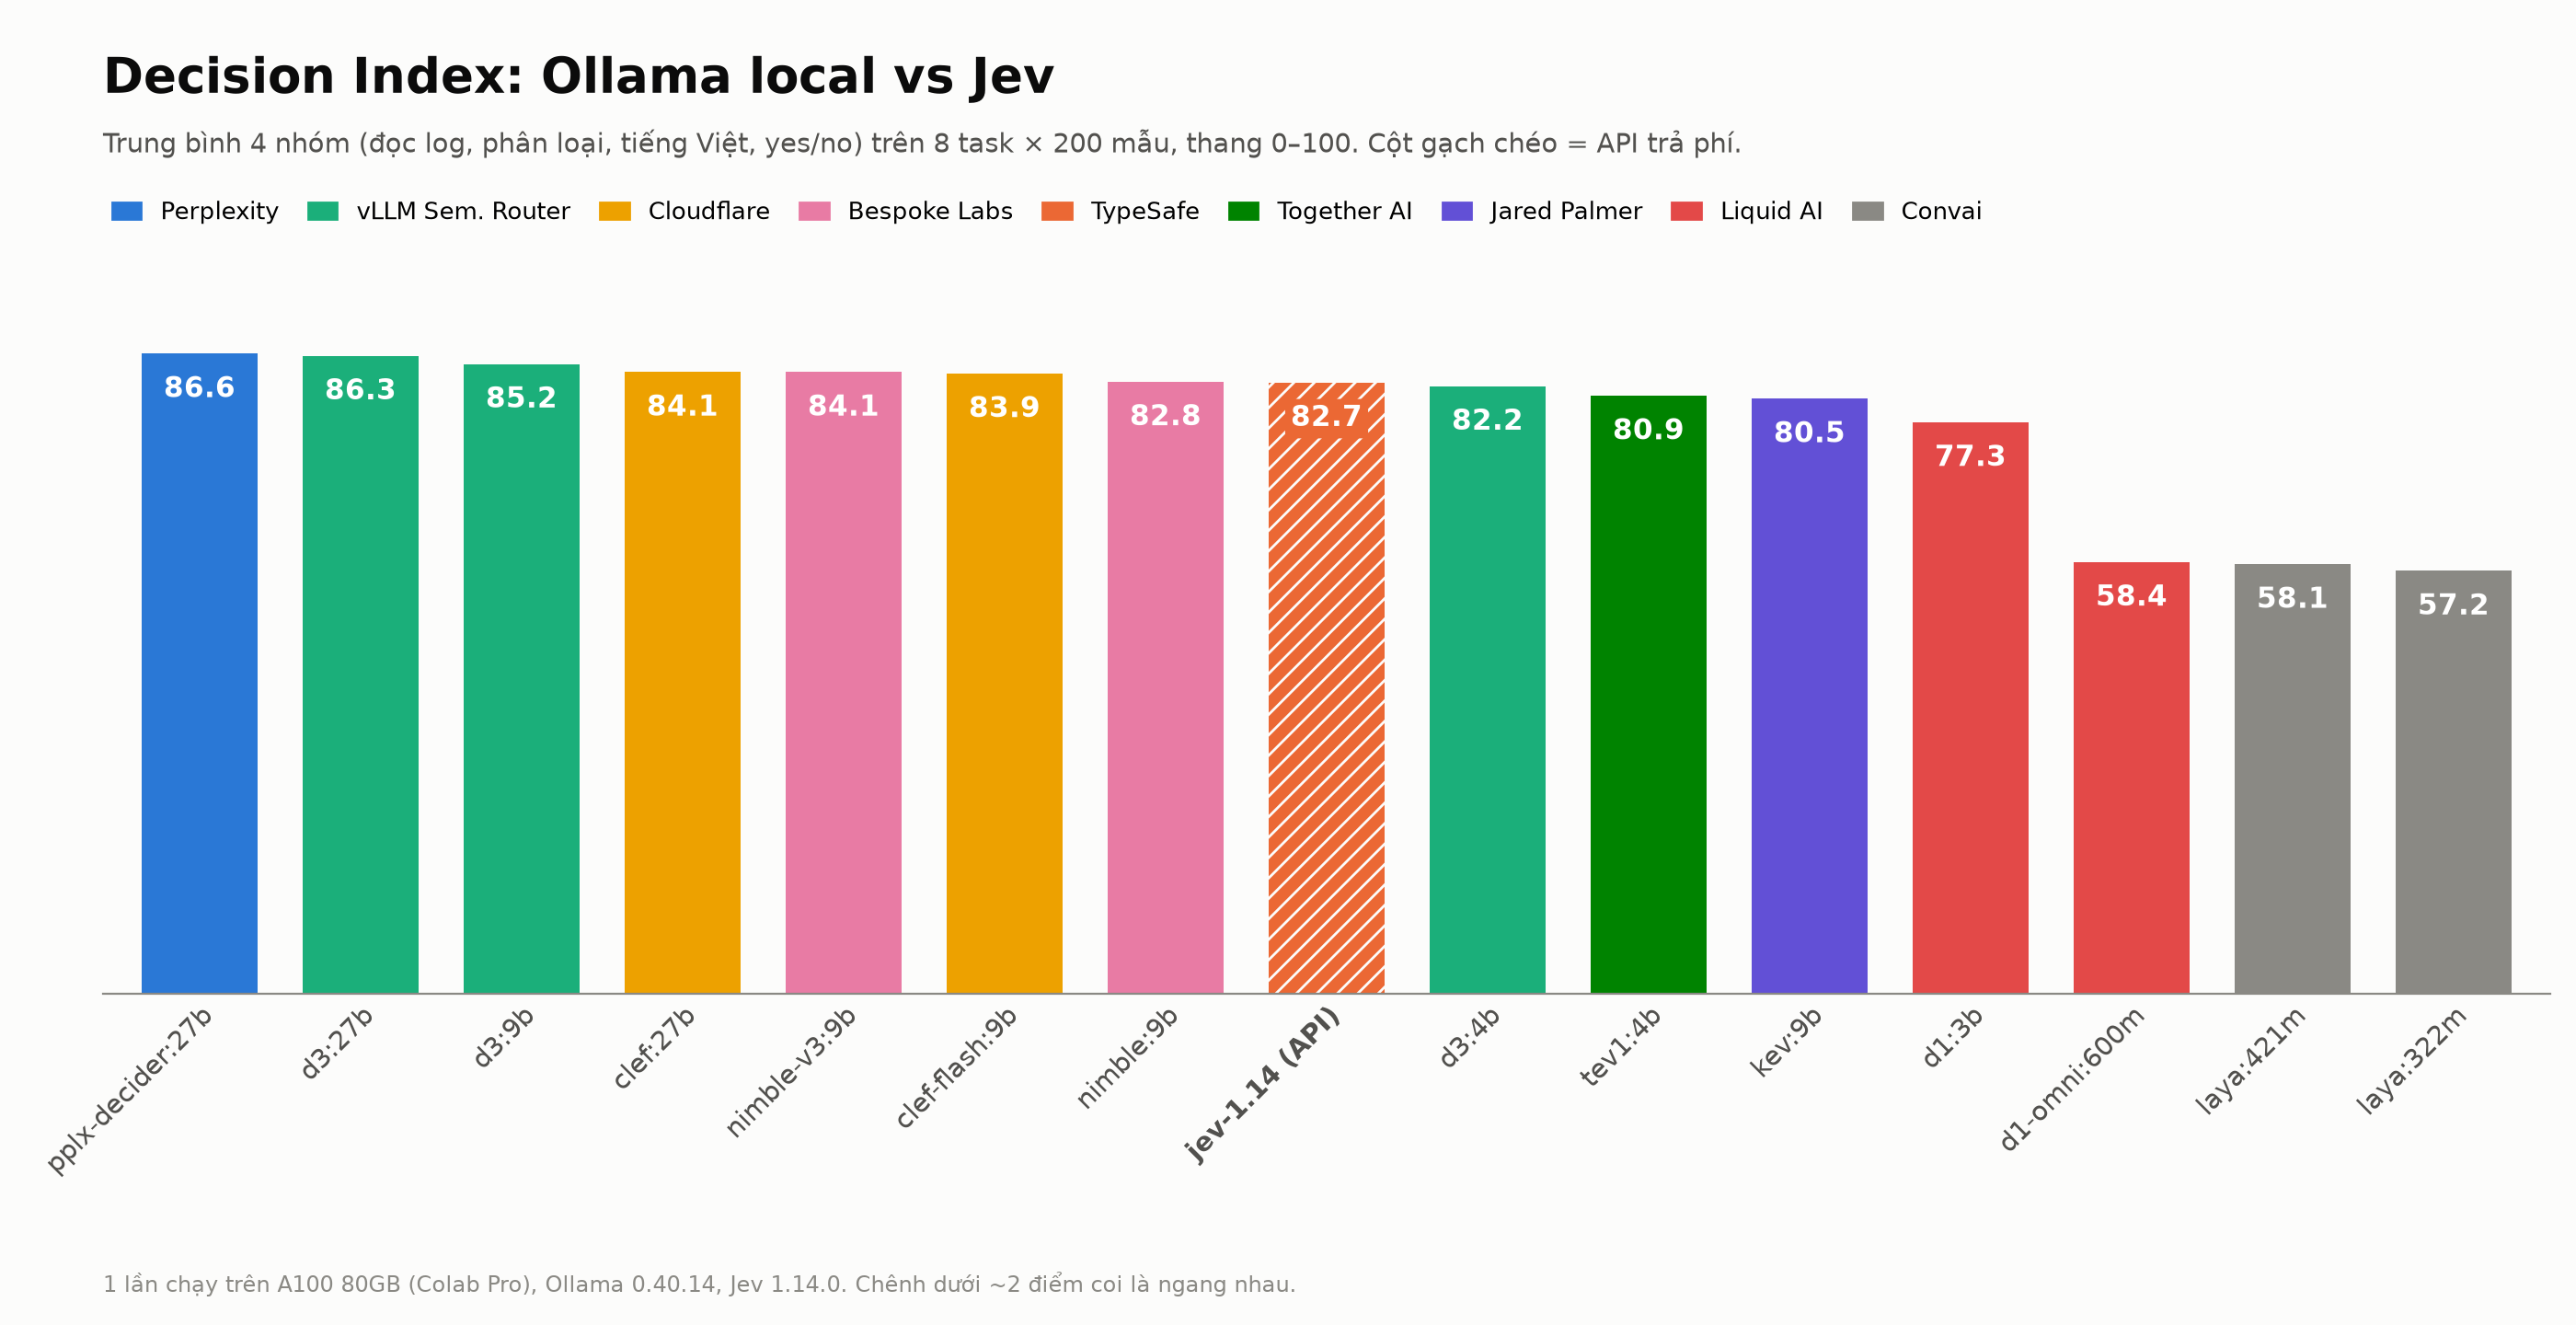
Hình 1. Decision Index trên thang 0–100; cột gạch chéo là Jev. Khoảng hai điểm được dùng như quy ước đọc thận trọng của báo cáo, không phải ngưỡng ý nghĩa thống kê đã được kiểm định.
Những kết quả đáng chú ý
- 9B là điểm cân bằng đáng thử.
d3:9bđạt 85,2 điểm với p50 303 ms và VRAM đỉnh 11,2 GB. Trong cùng họ, lên 27B chỉ tăng thêm 1,1 điểm trong lượt đo này. - Bảy cấu hình local có điểm quan sát cao hơn Jev. Mức chênh dao động từ rất nhỏ đến vài điểm; riêng
nimble:9bđạt 82,8 so với 82,7 của Jev, nên không có cơ sở để gọi đây là một chiến thắng rõ ràng. - Tác vụ tiếng Việt phân tách các model mạnh.
d1-omni:600mvàlaya:421mvẫn xử lý một số tác vụ tiếng Anh khá tốt, nhưng giảm mạnh trên hai tác vụ tiếng Việt. - Xếp hạng tốt chưa chắc phân loại tốt ở ngưỡng mặc định. Trên BGL, Jev và
clef:27bcó AUROC cao nhưng macro-F1 thấp hơn nhiều model khác. - API trả phí có thể khá rẻ. Jev có chi phí ước tính 0,0207 USD/1.000 quyết định với lượng token của bộ test này. Hạ tầng sẵn có và yêu cầu giữ dữ liệu local có thể quan trọng hơn khoản chênh chi phí nhỏ.
Decision model làm gì?
Ứng dụng thường chỉ cần một quyết định rõ ràng: yêu cầu này thuộc nhóm nào, log này có phải cảnh báo không, hoặc một review tương ứng mức điểm nào. Với decision model, chúng ta cung cấp state và các câu hỏi có kiểu để nhận câu trả lời có cấu trúc cùng xác suất, thay vì yêu cầu sinh một đoạn văn rồi tự phân tích lại.
Ba kiểu câu hỏi dùng trong benchmark là choice để chọn nhãn, noul để trả xác suất của câu trả lời “có”, và score để đánh giá theo các mức rubric. TypeSafe mô tả các kiểu đầu ra này trong tài liệu System One.
Ollama cung cấp endpoint /v1/systemone tương thích với cách hỏi của Jev. Trong phép thử, phần state và câu hỏi được giữ giống nhau cho từng mẫu; endpoint, tên model và cấu hình xác thực thay đổi theo backend. Điều này giảm khác biệt ở cách gọi API, dù vẫn còn khác biệt về checkpoint, lượng tử hóa, runtime và hạ tầng.
Chúng tôi đã thử như thế nào?
| Thành phần | Cấu hình |
|---|---|
| Phần cứng local | Google Colab Pro, NVIDIA A100 80 GB, High-RAM |
| Phần mềm | Ollama 0.40.14 |
| API đối chiếu | Jev jev-1.14.0, gọi từ cùng máy Colab |
| Số mẫu | 8 tác vụ × 200 mẫu = 1.600 quyết định/model |
| Lấy mẫu | Seed cố định 2026 |
| Mức song song | 4 request đồng thời cho cả local và Jev |
| Đầu vào | State cắt tối đa 2.000 ký tự; instruction và mô tả nhãn bằng tiếng Anh |
| Đầu ra hợp lệ | 100% với các model đã chạy thành công |
Con số 100% ở đây nói về đầu ra hợp lệ theo phép kiểm tra của benchmark, không phải tất cả câu trả lời đều đúng.
| Nhóm | Tác vụ | Dữ liệu | Thước đo |
|---|---|---|---|
| Đọc log | BGL alert cân bằng 100/100; đoán log level đã bị che; nhận diện nguồn log trong 16 hệ thống | LogHub | Macro-F1 |
| Phân loại | Intent tiếng Anh trong 18 domain; chấm review theo 5 mức sao | MASSIVE en-US; Yelp Review Full | Macro-F1; 1 − MAE/4 |
| Tiếng Việt | Intent trong 18 domain; cảm xúc phản hồi sinh viên, ba nhãn cân bằng | MASSIVE vi-VN; UIT-VSFC | Macro-F1 |
| Có/không | Trả lời dựa trên đoạn văn | BoolQ | Macro-F1 |
Điểm mỗi nhóm là trung bình các tác vụ trong nhóm. Decision Index là trung bình không trọng số của bốn nhóm, quy đổi lên thang 0–100. Vì vậy BoolQ, dù chỉ là một tác vụ, chiếm 25% điểm tổng. Đây là chỉ số tự tổng hợp của bộ test RTIC, không phải tỷ lệ trả lời đúng và không đồng nhất với các Decision Index do nhà phát hành công bố.
Bảng điểm tổng: nhóm đầu khá sát nhau
| Model | Decision Index | Đọc log | Phân loại | Tiếng Việt | Có/không |
|---|---|---|---|---|---|
| pplx-decider:27b | 86,6 | 80,1 | 90,6 | 82,3 | 93,3 |
| d3:27b | 86,3 | 83,1 | 88,8 | 79,9 | 93,3 |
| d3:9b | 85,2 | 78,1 | 88,3 | 80,2 | 94,3 |
| clef:27b | 84,1 | 70,7 | 90,8 | 80,6 | 94,3 |
| nimble-v3:9b | 84,1 | 82,6 | 87,8 | 74,7 | 91,3 |
| clef-flash:9b | 83,9 | 72,4 | 92,2 | 80,4 | 90,8 |
| nimble:9b | 82,8 | 79,3 | 89,3 | 73,5 | 89,2 |
| Jev 1.14 (API) | 82,7 | 72,0 | 88,3 | 79,4 | 91,2 |
| d3:4b | 82,2 | 68,9 | 88,2 | 79,3 | 92,3 |
| tev1:4b | 80,9 | 72,9 | 87,0 | 76,0 | 87,8 |
| kev:9b | 80,5 | 69,2 | 87,6 | 76,3 | 89,2 |
| d1:3b | 77,3 | 65,6 | 88,5 | 68,2 | 86,7 |
| d1-omni:600m | 58,4 | 56,7 | 85,9 | 20,7 | 70,3 |
| laya:421m | 58,1 | 61,6 | 68,8 | 21,9 | 80,0 |
| laya:322m | 57,2 | 42,8 | 63,8 | 56,8 | 65,3 |
Trong họ d3, điểm tăng từ 82,2 → 85,2 → 86,3 khi đi từ 4B lên 9B rồi 27B. Bước từ 9B lên 27B đổi thêm bộ nhớ và độ trễ để lấy một mức tăng điểm nhỏ hơn bước trước đó. Nếu đang định chọn 27B chỉ vì “lớn hơn chắc tốt hơn”, nên dành một lượt thử cho 9B trước.
Các thứ hạng sát nhau chỉ là thứ tự của lượt chạy này. Báo cáo chưa có khoảng tin cậy hay kiểm định để chứng minh các model tương đương hoặc vượt trội một cách ổn định.

Hình 2. Điểm từng tác vụ theo hình gốc của tác giả; ô đậm đánh dấu giá trị cao nhất trước khi hiển thị làm tròn. Cột điểm tổng bên trái dùng thang 0–1, tương ứng với thang 0–100 của bảng Decision Index.
Tiếng Việt: đừng chọn model chỉ từ điểm tiếng Anh
d1-omni:600m đạt 0,833 ở Intent EN nhưng chỉ 0,176 ở Intent VI; điểm cảm xúc tiếng Việt là 0,238. Với laya:421m, hai điểm tiếng Việt lần lượt là 0,175 và 0,264.
Biến thể đa ngôn ngữ laya:322m cải thiện rõ phần tiếng Việt, đạt 0,506 ở Intent VI và 0,629 ở cảm xúc, nhưng có điểm thấp hơn laya:421m ở các tác vụ còn lại. “Nhỏ” hay “đa ngôn ngữ” đều chưa đủ để đoán kết quả của một ứng dụng cụ thể.
Nhóm tiếng Việt cao nhất gồm pplx-decider:27b 82,3, clef:27b 80,6, clef-flash:9b 80,4 và d3:9b 80,2. Jev đạt 79,4, vẫn khá gần các lựa chọn này. Riêng tác vụ cảm xúc, tev1:4b có macro-F1 cao nhất: 0,794. Model dẫn điểm nhóm chưa chắc đứng đầu mọi tác vụ trong nhóm.
MASSIVE vi-VN là dữ liệu dịch; UIT-VSFC là phản hồi sinh viên. Bộ test cho một sản phẩm tiếng Việt vẫn nên có thuật ngữ chuyên ngành, tên riêng và cách diễn đạt thực tế của người dùng sản phẩm đó.
Phân loại: clef-flash dẫn nhóm; đọc log lại là chuyện khác
clef-flash:9b đạt 92,2 điểm ở nhóm phân loại, với 0,927 trên Intent EN và 0,916 trên Yelp. Cả hai đều là giá trị cao nhất của tác vụ tương ứng trong bảng kết quả.
Ở nhóm log, hai điểm cao nhất thuộc về d3:27b 83,1 và nimble-v3:9b 82,6; Jev đạt 72,0. Nhưng nhìn riêng macro-F1 có thể bỏ qua một phần câu chuyện.
| Model | BGL macro-F1 | BGL AUROC | BGL Brier |
|---|---|---|---|
| d3:27b | 0,873 | 0,989 | 0,108 |
| d3:9b | 0,914 | 0,967 | 0,097 |
| clef:27b | 0,571 | 0,982 | 0,224 |
| Jev 1.14 (API) | 0,643 | 0,975 | 0,176 |
Jev và clef:27b vẫn xếp hạng các mẫu BGL tốt theo AUROC, dù macro-F1 ở ngưỡng mặc định 0,5 thấp hơn. Đây là lý do nên kiểm tra đường cong theo ngưỡng và chất lượng xác suất trước khi loại một model khỏi hệ thống cảnh báo.
Brier càng thấp càng tốt, nhưng không phải thước đo riêng của hiệu chuẩn xác suất. Nó còn chịu ảnh hưởng của khả năng phân biệt; chỉ từ Brier và AUROC chưa thể chẩn đoán đầy đủ nguyên nhân sai lệch. Tài liệu scikit-learn giải thích cách đọc thước đo xác suất này.
Trên BoolQ, d3:9b và d3:27b cùng có Brier 0,043, thấp nhất ở tác vụ này trong bảng xác suất được cung cấp. Đây là một điểm đáng chú ý khi ứng dụng cần dùng trực tiếp xác suất để ra quyết định.
Brief cũng ghi nhận những dòng có chữ FATAL nhưng nhãn BGL là bình thường. Điều này cho thấy mức độ nghiêm trọng trong nội dung log và nhãn bất thường của bộ dữ liệu không nên bị đồng nhất. Bước tiếp theo hợp lý là chọn ngưỡng trên tập validation riêng rồi đánh giá lại trên test; benchmark hiện chưa đo mức cải thiện sau khi chọn lại ngưỡng.
Độ trễ, bộ nhớ và chi phí: local có hóa đơn riêng
Độ trễ được đo từ client với bốn request đồng thời. Số của Jev bao gồm đường mạng từ Colab đến API; A100 là GPU chạy các model local, không phải cấu hình máy chủ được xác nhận của Jev.
| Model | p50 (ms) | p95 (ms) | VRAM đỉnh (GB) | USD/1.000 quyết định |
|---|---|---|---|---|
| pplx-decider:27b | 867 | 1.155 | 19,9 | 0,0531 |
| d3:27b | 870 | 1.152 | 30,7 | 0,0532 |
| d3:9b | 303 | 400 | 11,2 | 0,0186 |
| clef:27b | 1.031 | 1.629 | 32,2 | 0,0714 |
| nimble-v3:9b | 214 | 352 | 17,3 | 0,0153 |
| clef-flash:9b | 373 | 556 | 13,4 | 0,0253 |
| nimble:9b | 212 | 350 | 16,5 | 0,0152 |
| Jev 1.14 (API) | 217 | 259 | — | 0,0207 |
| d3:4b | 203 | 258 | 7,0 | 0,0124 |
| tev1:4b | 147 | 289 | 9,5 | 0,0203 |
| kev:9b | 195 | 281 | 18,9 | 0,0122 |
| d1:3b | 101 | 124 | 4,3 | 0,0060 |
| d1-omni:600m | 34 | 48 | 3,8 | 0,0045 |
| laya:421m | 43 | 52 | 1,2 | 0,0027 |
| laya:322m | 35 | 41 | 1,2 | 0,0022 |
Jev có p50 217 ms và p95 259 ms dù đã tính mạng. Các model 27B local có p95 từ 1.152 đến 1.629 ms. Một số model nhỏ còn nhanh hơn Jev, nên bảng này không chứng minh API có độ trễ thấp nhất toàn bộ nhóm.
Chi phí local được tác giả quy đổi theo thời gian chạy và giá A100 Colab Pro ước tính khoảng 0,89 USD/giờ, chưa tính tải model và thời gian GPU chờ. Đây không phải tổng chi phí sở hữu một dịch vụ local.
Jev tính 0,042 USD cho một triệu token đầu vào, miễn phí token đầu ra theo bảng model của TypeSafe. Lượt benchmark dùng khoảng 790 nghìn token cho 1.600 request, tổng khoảng 0,033 USD, tương ứng 0,0207 USD/1.000 quyết định. Chi phí trên một quyết định sẽ thay đổi theo độ dài state và câu hỏi.
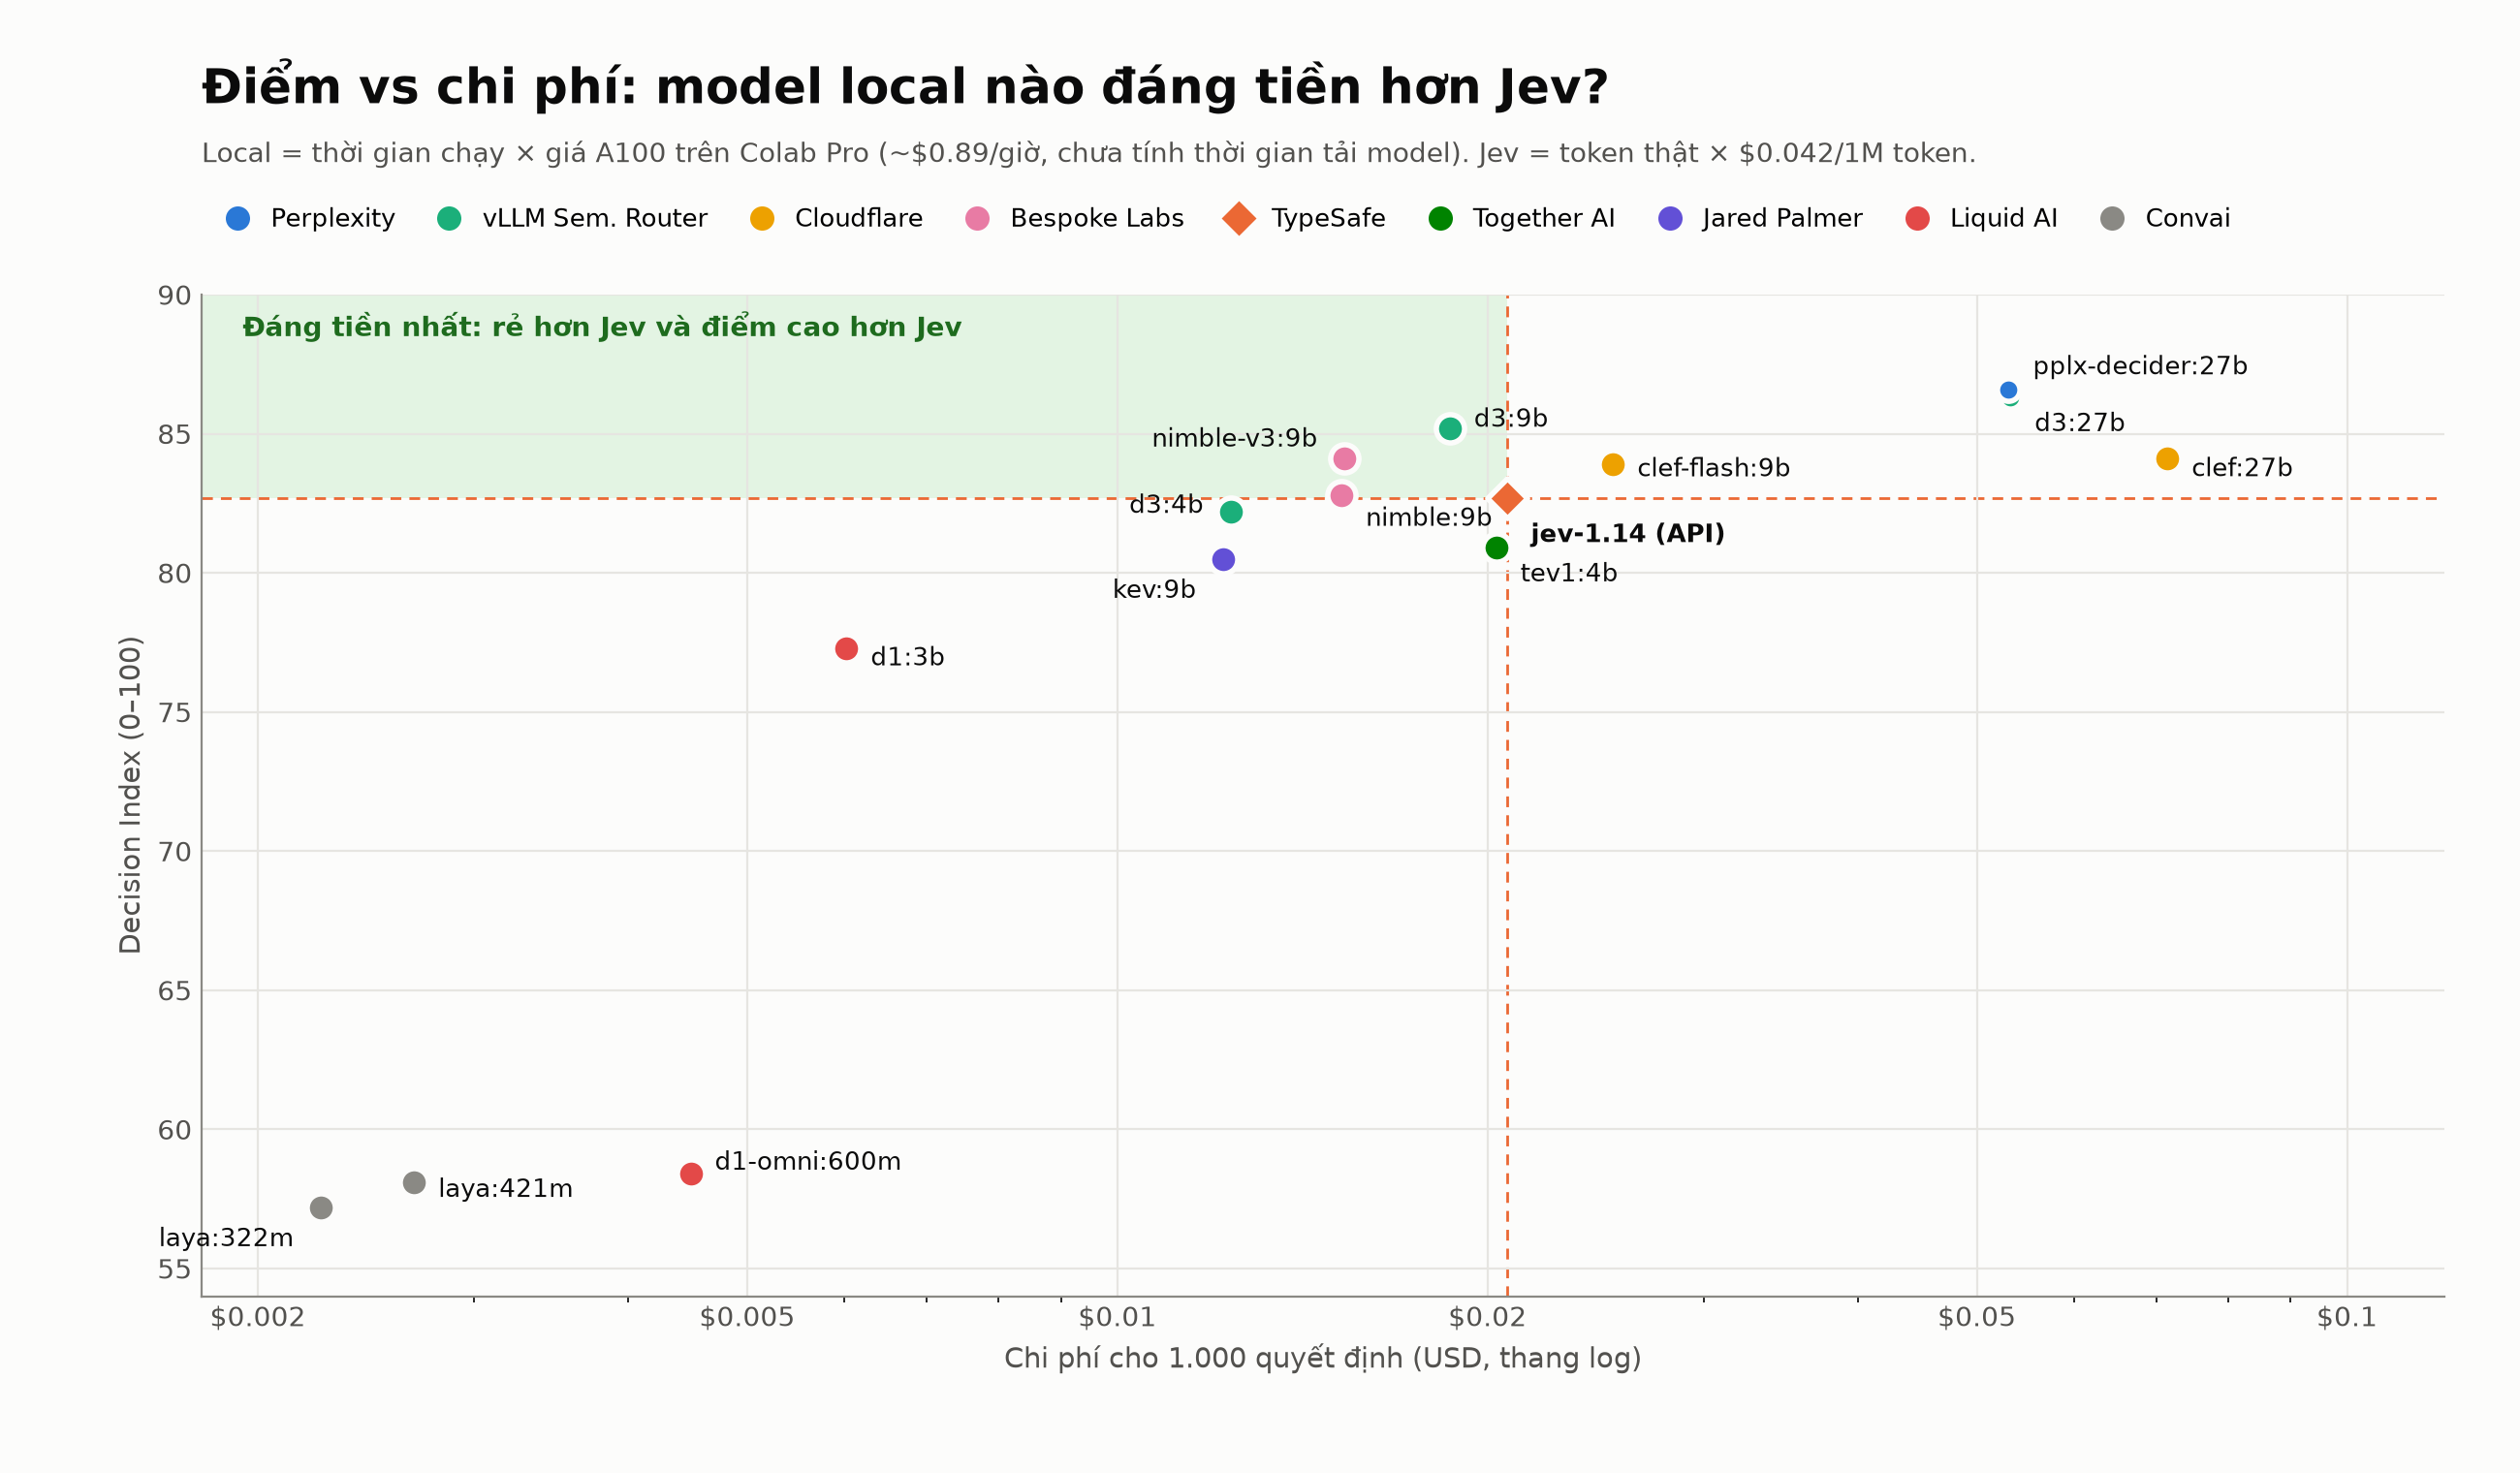
Hình 3. d3:9b, nimble-v3:9b và nimble:9b có điểm quan sát cao hơn và chi phí ước tính thấp hơn Jev trong cấu hình này. Trục chi phí dùng thang log. Vùng màu không biểu thị ưu thế có ý nghĩa thống kê.
Với độ dài đầu vào tương tự bộ test, một triệu quyết định qua Jev được ước tính khoảng 21 USD. Vì vậy, khi chọn local hay API, nên đặt thêm câu hỏi: đã có GPU chưa, dữ liệu có được phép rời hệ thống không, có cần offline không và ai sẽ vận hành dịch vụ? GPU vẫn cần được cấp tài nguyên, kể cả khi trọng số model tải về được.
Lựa chọn cá nhân của tác giả
| Nhu cầu | Ứng viên nên thử | Lý do trong bộ test này |
|---|---|---|
| Cân bằng chất lượng, độ trễ và bộ nhớ | d3:9b | 85,2 điểm; p50 303 ms; VRAM đỉnh 11,2 GB |
| Ưu tiên điểm tổng, có GPU lớn | pplx-decider:27b; d3:27b | Hai điểm tổng cao nhất: 86,6 và 86,3 |
| Không muốn vận hành GPU | Jev 1.14 API | 82,7 điểm; p95 259 ms; chi phí đầu vào thấp trong lượt đo |
| Đọc và phân loại log | d3:27b; thử thêm d3:9b | Điểm nhóm log tốt; vẫn cần kiểm tra ngưỡng theo dữ liệu thực tế |
| Intent tiếng Anh và chấm review | clef-flash:9b | Dẫn nhóm phân loại ở mức 92,2 |
| Nội dung tiếng Việt | pplx-decider:27b; thử thêm clef:27b, d3:9b | Nằm trong nhóm điểm tiếng Việt cao |
| Hạn chế tài nguyên | d1:3b; thử thêm d3:4b | d1:3b đạt 77,3 điểm với VRAM đỉnh 4,3 GB |
Các giá trị VRAM là số đo trong cấu hình thử, không phải cam kết dung lượng tối thiểu cho mọi deployment. Ngoài chất lượng, cần đọc giấy phép đúng phiên bản: nimble-v3 được công bố theo CC BY-NC 4.0, khác với bản nimble trước đó dùng Apache 2.0.
Hạn chế của phép thử
- Một lượt chạy, 200 mẫu/tác vụ, chưa có khoảng tin cậy. Khoảng hai điểm Index là quy ước đọc thận trọng, không chứng minh hai model tương đương hoặc khác biệt có ý nghĩa thống kê.
- Định dạng trọng số khác nhau.
pplx-deciderdùng q4_K_M; d3, clef, clef-flash và d1 dùng q8_0; nimble, nimble-v3, kev, tev1 và d1-omni dùng các tag bf16 đã ghi trong brief. Đây là so sánh các cấu hình phục vụ thực tế, không tách riêng tác động của lượng tử hóa. - Instruction và mô tả nhãn đều bằng tiếng Anh, kể cả khi state là tiếng Việt. Kết quả chưa đại diện cho mọi cách viết prompt tiếng Việt.
- State bị giới hạn 2.000 ký tự; bộ test không đánh giá khả năng xử lý ngữ cảnh dài của các model.
- Tám tác vụ không bao phủ mọi ứng dụng. Dữ liệu dịch, văn phong phản hồi sinh viên và nhãn BGL đều có đặc thù; chưa có tác vụ ảnh hoặc âm thanh.
- Độ trễ phụ thuộc môi trường và mức song song. Local chạy trên một A100; thời gian Jev còn có mạng và hạ tầng API. Chưa có kết quả đủ để suy ra throughput hoặc chi phí ở mức tải khác.
- Chi phí local chưa gồm tải model, GPU rảnh và công vận hành. Các ước tính chi phí gắn với giá và lượng token của lượt thử ngày 03/11/2026.
- Có cấu hình không chạy được trên A100 trong môi trường đã thử.
strands-decider,kev:27b,d1-omni:2bvà tag 8-bit dự định củapplx-deciderkhông vào bảng điểm. Đây là giới hạn của các gói/backend đã thử, không phải kết luận rằng mọi định dạng NVFP4 hoặc MXFP8 đều chỉ chạy trên Mac.
Mang kết quả vào một sản phẩm thực tế
Bắt đầu bằng một danh sách ngắn phù hợp tài nguyên: chẳng hạn d3:9b khi đã có GPU, hoặc Jev khi muốn gọi API. Sau đó thử trên dữ liệu của ứng dụng, giữ một tập test độc lập, kiểm tra cả xác suất và ngưỡng ra quyết định, rồi đo lại độ trễ, bộ nhớ và chi phí với mức tải dự kiến.
Một model đạt điểm tổng cao có thể chưa phù hợp với trường hợp lỗi quan trọng nhất của sản phẩm. Bảng benchmark hữu ích nhất khi giúp chúng ta biết nên thử ai tiếp theo và cần đo thêm điều gì.
Nguồn và khả năng tái lập
Tải phụ lục số liệu benchmark (PDF, 6 trang)
Toàn bộ số đo trong bài lấy từ brief benchmark do Hồ Việt Anh (RTIC) cung cấp cho lượt chạy 03/11/2026. Chúng tôi không chạy lại benchmark khi biên tập bài. Notebook được tác giả nêu là decision_benchmark_colab.ipynb; tên tag thực chạy và bảng số liệu đầy đủ được giữ trong phụ lục dữ liệu kèm theo.
- LogHub
- MASSIVE en-US, bản SetFit và MASSIVE vi-VN, bản SetFit
- Yelp Review Full
- UIT Vietnamese Students Feedback
- BoolQ
- Tài liệu System One của Ollama và model/giá Jev của TypeSafe
- Bài trước: benchmark 17 embedding model Ollama của RTIC
Đọc tiếp
RTIC / Journal
Thảo luận và góp ý
Đặt câu hỏi, chia sẻ bằng chứng hoặc góp ý để hoàn thiện bài viết.
Đăng nhập GitLab RTIC để bình luận hoặc đánh dấu nội dung hữu ích. Đăng nhập thành viên →
oh mai gotto